Het contentaanbevelingsalgoritme van Google is een black box. Zo bepaalt het wat het je laat zien.
 indignatieai-redactie
6 min read
Als je een van de miljoenen dagelijkse gebruikers van Google Discover bent, ben je ongetwijfeld al allerlei soorten content tegengekomen zonder er actief naar te zoeken. Een Spaanse gebruiker kan bijvoorbeeld krantenkoppen zien die beloven de geheime recepten van avant-garde chef-kok Ferràn Adrià te onthullen, hoe laat de 46-jarige tv-presentatrice Pilar Rubio naar bed gaat, de nieuwste onmisbare aanbiedingen van Lidl, of de nieuwe auto waarmee ze “adiós” kunnen zeggen tegen de jaarlijkse APK-keuring.
We beschouwen Google nog steeds in de eerste plaats als een zoekmachine. De iconische zoekbalk op een witte achtergrond – Alphabets vlaggenschipproduct dat de basis vormt voor de aanzienlijke advertentie-inkomsten – is al lang onderdeel van onze woordenschat, zowel als zelfstandig naamwoord als als werkwoord dat het laatste woord heeft in verhitte discussies.
Maar in de loop der jaren heeft Google een andere dienst ontwikkeld, die verder gaat dan traditioneel ‘zoeken’ en zich richt op algoritmisch ‘vinden’. Google Discover, het systeem voor contentaanbevelingen , heeft een interface die lijkt op een socialemediafeed, maar dan zonder reacties, retweets of zichtbare interacties van andere gebruikers.
In tegenstelling tot andere Google-diensten zoals Maps, Drive of Foto’s, heeft Discover geen eigen app . In plaats daarvan is het vooraf geïnstalleerd op Android-telefoons als een integraal onderdeel van de interface en is het meestal te openen door naar rechts te vegen op het startscherm.
De grote vraag bij dit en elk ander aanbevelingssysteem – van controversiële algoritmes zoals die van Instagram en Facebook , tot Netflix , YouTube en zelfs ogenschijnlijk onschuldige diensten zoals Vinted – is hoe het systeem bepaalt welke content het je aanbeveelt. Wat heb jij als gebruiker gedaan om dit op je telefoon te verdienen?
Geen magische formule
Wanneer mensen proberen uit te leggen hoe platforms ons content aanbevelen, grijpen ze vaak terug op algoritmische verzinsels , roddels of ongefundeerde overtuigingen . Sommigen proberen zelfs het algoritme te trainen of te manipuleren op basis van deze reconstructies.
De waarheid is echter dat er geen enkel algoritme of grote formule bestaat die je kunt beheersen. Aanbevelingssystemen zoals Google Discover worden aangedreven door een enorm, ondoorzichtig netwerk van algoritmische infrastructuur , een circuit van computerinstructies verborgen in een metaforische zwarte doos waarover Google zeer weinig details heeft prijsgegeven.
Al het overige dat we weten, komt voort uit professionele inspanningen om te leren hoe het werkt, of uit wetenschappelijke literatuur, waarin de impact ervan op vakgebieden zoals de journalistiek is beschreven .
De ingrediënten van deze systemen zijn echter niet zomaar af te lezen, zoals het etiket op een fles ketchup of shampoo.
Content kanaliseren
De website van Google definieert Discover als een gepersonaliseerde feed op basis van de interesses van de gebruiker, bepaald door hun activiteit op het web en in apps. Wetenschappelijke studies gepubliceerd door Google’s eigen ingenieurs hebben aangetoond dat het een contentaanbevelingssysteem op industriële schaal is, terwijl onafhankelijk academisch onderzoek het plaatst op het snijvlak van informatie retrieval en algoritmische curatie .
Hoewel we niet precies weten hoe het werkt, kunnen we verklaren waarom Google Discover bepaalde content toont door te kijken naar de typische architectuur van een aanbevelingssysteem , samen met het bewijsmateriaal en de hypotheses die we hebben over het product van Google.
Een handige metafoor is die van een trechter die in verschillende fasen is verdeeld. Dagelijks worden er miljoenen soorten content online gepubliceerd, van artikelen en lange video’s tot berichten op sociale media en AI-samenvattingen. Discover filtert deze enorme variëteit tot een lijst die specifiek is afgestemd op elke gebruiker.
De eerste filters
Net als bij Google Search is de eerste stap indexering . Google beheert een database waarin het internet wordt doorzocht en een eerste filter toepast om alles uit te sluiten wat niet aan het beleid voldoet. Dit zorgt ervoor dat content die de veiligheidsregels schendt, vanaf het begin wordt uitgesloten. Dit omvat bijvoorbeeld berichten die oproepen tot het rekruteren van mensen voor een terroristische organisatie, of schokkende afbeeldingen zonder journalistieke context.
Het feit dat de content dit filter passeert, betekent echter alleen dat deze in aanmerking komt. Het garandeert niet dat de content ook daadwerkelijk in je feed verschijnt.
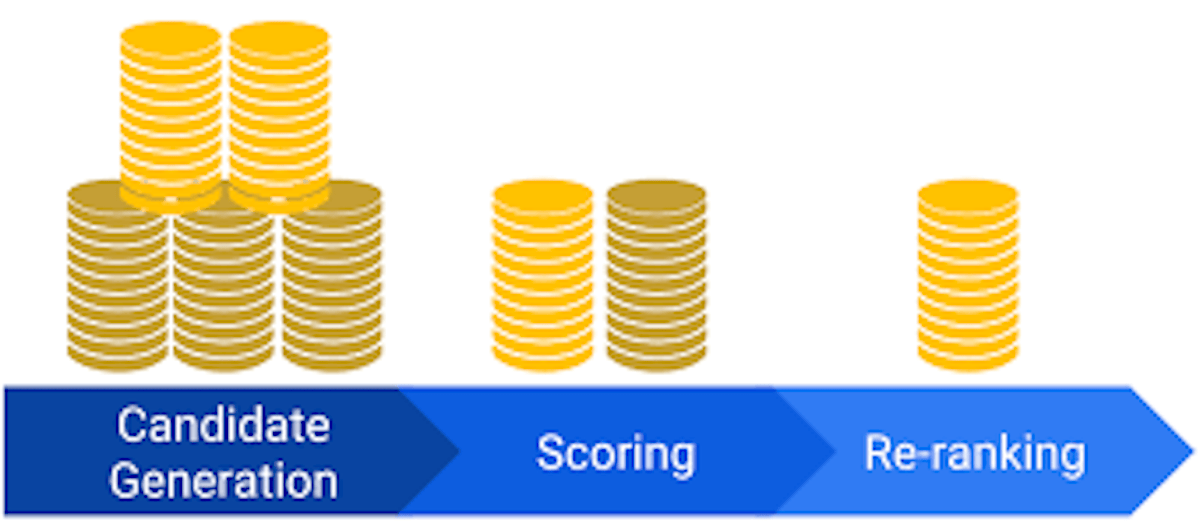
Om deze eerste selectie te verkleinen, identificeert het systeem vervolgens welke content het meest waarschijnlijk aansluit bij uw interesses. Google Discover doet dit door te identificeren welke specifieke elementen (entiteiten genoemd) aanwezig zijn in uw zoekopdrachten of interacties – zoals Ferràn Adriá, Pilar Rubio en Lidl – en deze met elkaar te verbinden. Op deze manier kan het systeem interpreteren welke ogenschijnlijk ongerelateerde zoekopdrachten of artikelen deel uitmaken van dezelfde interesse en deze ordenen in bredere onderwerpen en subonderwerpen.
Nadat het systeem je interesses in kaart heeft gebracht, moet het deze vertalen naar een taal waarin het op grote schaal gerelateerde content kan vergelijken en vinden. In het geval van Google Discover hebben analisten zoals Damien Andell gesuggereerd dat het gebruikmaakt van wiskundige representaties die bekend staan als embeddings .
Deze vectoren zetten groepen entiteiten (clusters genoemd) en uw eigen interesses om in coördinaten op een enkel bord dat lijkt op een spelletje zeeslag. Hoe dichter twee punten bij elkaar liggen, hoe groter hun verwantschap.
Het bijhouden van klikken, likes en zooms.
Zodra deze clusters zijn geïdentificeerd, versmalt de trechter zich weer tot voorspellende modellen. Hier probeert de AI van het systeem te voorspellen hoe u op elk van de opties zult reageren.
De ingenieurs van Google beschrijven elf voorspellende doelstellingen, waarvan er zeven gespecificeerd zijn : vijf positieve (klikken, liken, positief reageren op een enquête, klikken om details te bekijken en klikken om tekst uit te breiden) en twee negatieve (inhoud negeren of permanent blokkeren).
Met al deze voorspellingen op tafel verwerkt het systeem ze vervolgens om de kandidaten te rangschikken. De gebruikelijke aanpak is om ze te combineren tot één score, waarbij sommige signalen meer gewicht krijgen dan andere. Een artikel kan bijvoorbeeld een hoge kans hebben dat je erop klikt, maar ook een hoge kans dat je het blokkeert; een ander artikel kan minder directe nieuwsgierigheid opwekken, maar meer positieve signalen genereren.
Discover moet deze afweging maken om te bepalen wat als eerste en wat als volgende verschijnt. Google heeft echter niet bekendgemaakt hoe het deze voorspellingen combineert.
Nadat de kandidaten zijn gerangschikt, passen sommige systemen een laatste filter toe om criteria zoals diversiteit, actualiteit of objectiviteit mee te nemen. Dit voorkomt dat de top vijf content bijvoorbeeld allemaal over dezelfde onmisbare nieuwe gadget van Lidl gaat.
Een eindeloze lus
We zijn nu aan het einde van de trechter en Google Discover heeft bepaald wat je te zien krijgt. Maar het proces stopt daar niet. Het systeem geeft feedback en observeert de signalen die je genereert, zowel expliciet (wanneer je een bron blokkeert of een stuk content leuk vindt) als impliciet (of je stopt om een artikel te lezen of doorgaat naar het volgende).
Deze nieuwe gegevens worden teruggekoppeld naar het systeem om het model te trainen en bij te werken. Aanbevelingen genereren interacties, interacties produceren nieuwe gegevens en die gegevens worden gebruikt voor toekomstige aanbevelingen.
We kunnen niet precies weten welke combinatie van signalen ertoe leidt dat Ferràn Adrià, Pilar Rubio of een andere naam in je Discover-feed verschijnt. Wat we wel weten, is dat het systeem een eindeloos kansspel is, dat zich voedt met je geschiedenis en locatie, evenals kleine, alledaagse gedragingen die, hoewel onmerkbaar voor jou, de data leveren die dit enorme aanbevelingssysteem voeden.