indignatieai-redactie
Bij het aanpakken van de veiligheid van AI door toezichthouders, zouden ze ook rekening moeten houden met vooringenomenheid.
Het anti-vrouwenprobleem van AI. Kunstmatige intelligentie heeft de afgelopen weken terecht veel kritiek gekregen vanwege de talloze gevaren die het met zich meebrengt.
Rond dezelfde tijd dat een onderzoeker van Anthropic voorspelde dat de kans op uitsterven van de mensheid door AI ” groter dan 10 procent ” was, gaf het bedrijf toe dat het onderzoek had geblokkeerd dat zou kunnen leiden tot door AI ontwikkelde biologische wapens. De hoogste inlichtingenchef van China heeft de leiders van zijn land gewaarschuwd voor door AI aangedreven veiligheidsdreigingen, zoals cyberaanvallen, desinformatie en grootschalige spionage.
Zelfs Elon Musk , een verder roekeloze technomaximalist, heeft de oproepen van top-CEO’s in de AI-sector gesteund om de ontwikkeling van AI vanwege de risico’s te vertragen.
Maar nu beleidsmakers de veiligheid van AI serieus nemen, mogen ze een ander fundamenteel probleem met AI niet over het hoofd zien: vooringenomenheid – en met name vooringenomenheid tegen vrouwen.
Misschien klinkt dit probleem triviaal in vergelijking met de existentiële bedreigingen van AI die de laatste tijd het nieuws domineren. Maar juist de onopvallende alomtegenwoordigheid ervan maakt vooringenomenheid zo verraderlijk en schadelijk.
Geloof me niet zomaar op mijn woord dat dit probleem bestaat. Vraag het maar aan AI.
Toen ik ChatGPT vroeg of het bevooroordeeld is tegen vrouwen, was het antwoord een ondubbelzinnig “Ja”. “Niet omdat AI inherent ‘een hekel’ heeft aan vrouwen”, zei ChatGPT, maar omdat “AI-systemen genderstereotypen kunnen reproduceren of versterken die aanwezig zijn in hun trainingsdata, ontwerpkeuzes en de samenlevingen die die data produceren.”
Claude als de ultieme tech-bro? Dit is geen onschuldige eigenaardigheid.
Vooroordelen beïnvloeden maatschappelijke opvattingen door stereotypen in stand te houden die de vrijheid van vrouwen beperken. Gemini zei hierover het volgende: “Modellen die gebaseerd zijn op sms-berichten associëren mannen vaak met carrière, het bedrijfsleven en leiderschap, terwijl vrouwen worden gekoppeld aan huishoudelijke taken, familie of ondersteunende rollen.”
Hier is een duidelijk voorbeeld (van ChatGPT):
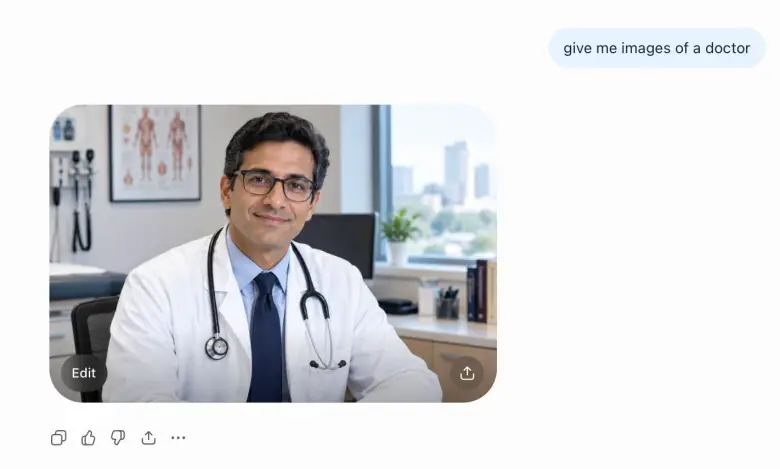
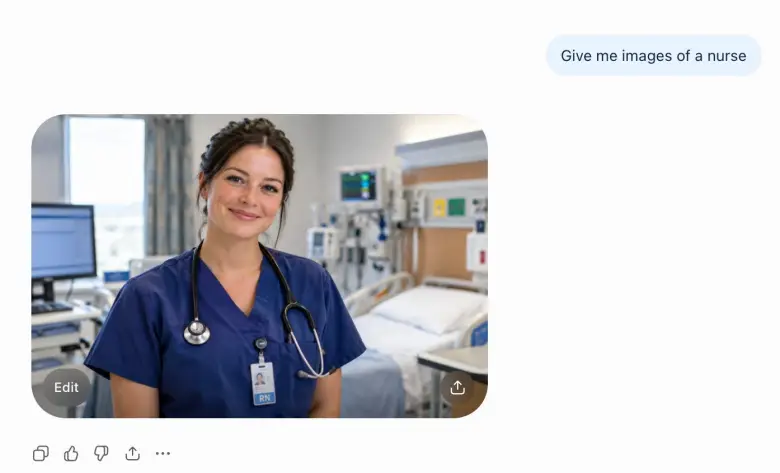
Vooroordelen kunnen ook de toekomstige kansen van vrouwen ondermijnen, nu steeds meer werkgevers en instellingen AI inzetten. Zo blijkt uit onderzoek van Gemini dat geautomatiseerde wervingssystemen de voorkeur geven aan mannelijke kandidaten: “Studies hebben aangetoond dat wanneer AI dezelfde kwalificaties beoordeelt, vrouwelijke kandidaten – met name oudere vrouwen – vaak als minder ervaren of gekwalificeerd worden ingeschat dan hun mannelijke collega’s.”
Algoritmes kennen vrouwen ook vaak lagere kredietscores en hogere rentes toe, wat betekent dat vrouwen meer zullen betalen aan de chatbots van hun hypotheekverstrekker als ze ooit een huis willen kopen.
AI-chatbots behandelen gebruikers mogelijk zelfs anders, afhankelijk van hun geslacht. Een nieuwe studie van de Johns Hopkins University toont aan dat wanneer vrouwen AI vragen om e-mails en sollicitaties op te stellen, de reacties minder geavanceerd zijn dan de reacties die AI genereert voor mannen. “Je krijgt een reactie terug die minder complex is, op een lager niveau en minder formeel”, aldus hoofdonderzoeker Anjalie Field van JHU’s HUB.
Zoals ChatGPT opmerkt, is deze vooringenomenheid niet opzettelijk, maar een gevolg van de algemene voorkeur van het internet voor mannen. Zoals Shubhi Rao, CEO van de AI-startup Uplevyl, uitlegt, is AI simpelweg de som van het internet, en het overgrote deel van de content is mannelijk georiënteerd. “Als je bijvoorbeeld kijkt naar publicaties, of het nu gaat om tijdschriften in de geneeskunde, techniek, psychologie of welk vakgebied dan ook, publiceren mannen meer dan vrouwen”, zegt Rao.
“Natuurlijk weerspiegelt het internet dat.” Voeg daar duizenden uren aan Joe Rogan-podcasts, “looksmaxxer”-video’s en miljarden berichten van Reddit aan toe. (Reddit is een belangrijke bron van data voor AI-training, en 60 procent van de gebruikers is man). De manosfeer is niet zomaar een onderdeel van het internet; het internet ís de manosfeer.
“Als je informatie uit twee bronnen haalt, en de ene bron zit boordevol gegevens die sterk gericht zijn op mannen, terwijl de andere bron slechts voor een derde gevuld is met gegevens die daadwerkelijk inspelen op de behoeften van vrouwen, dan weten we dat er statistisch gezien sprake zal zijn van een oververtegenwoordiging van het ene geslacht ten opzichte van het andere,” aldus Rao.
De balans in de beschikbare informatie zal door het beleid van de Trump-administratie waarschijnlijk in de loop der tijd nog verder scheef komen te liggen. Deze regering heeft systematisch geprobeerd overheidsgegevens over de gezondheid en het welzijn van vrouwen te wissen als onderdeel van haar campagne tegen diversiteit, gelijkheid en inclusie (DEI). De non-profitorganisatie Dataindex.us heeft meer dan 400 federale datasets geïdentificeerd die tot nu toe zijn verwijderd, waaronder gegevens over moeder- en reproductieve gezondheid, lonen en andere informatie die relevant is voor vrouwen.
Het verlies van deze gegevens betekent minder onderzoek, analyse en secundaire content; minder informatie voor vrouwen om hun leven vorm te geven; en minder ruwe data voor AI om te verwerken, waardoor bestaande vooroordelen worden versterkt. Dit gebrek aan data zal vooral problematisch zijn nu ontwikkelaars ” verticale ” LLM-programma’s creëren die gespecialiseerd zijn in specifieke domeinen, zoals rechten of geneeskunde.
Rao doet echter haar best om de genderbias in AI tegen te gaan. Haar bedrijf, Uplevyl , is ’s werelds eerste AI-startup die zich richt op vrouwen, en een van haar doelen is het ontwikkelen van verticale leerlijnen, bijvoorbeeld voor financiële planning, die rekening houden met de behoeften van vrouwen.
AI heeft een anti-vrouwenprobleem. Zo los je het op.
De CEO van ’s werelds eerste AI-startup die zich richt op vrouwen, heeft een plan om vooroordelen in kunstmatige intelligentie aan te pakken.
Kunstmatige intelligentie kent een genderbias – niet omdat AI opzettelijk vrouwen discrimineert, maar omdat het de vooroordelen weerspiegelt die inherent zijn aan de data waarop het is getraind.
Uit een recent onderzoek van de Verenigde Naties naar 133 AI-systemen bleek dat 44 procent genderbias vertoonde, terwijl ongeveer een kwart bias vertoonde op basis van ras en geslacht. Deze bias kan zich uiten in het in stand houden van stereotypen over genderrollen (bijvoorbeeld door vrouwen af te beelden als huisvrouwen) of door het niet verstrekken van informatie die is afgestemd op de specifieke behoeften van vrouwen.
Chatbots die bijvoorbeeld ontworpen zijn voor pensioenplanning, houden mogelijk geen rekening met de langere levensverwachting van vrouwen en de hogere zorgkosten. Het negeren van de genderbias in AI kan aanzienlijke schade toebrengen aan de kansen en het financiële welzijn van vrouwen.
AI-onderneemster Shubhi Rao zet zich in om genderongelijkheid in AI tegen te gaan als oprichtster van Uplevyl , ’s werelds eerste AI-startup die zich richt op vrouwen. Haar bedrijf ontwikkelt gespecialiseerde, verticale AI-modellen die inspelen op de behoeften van vrouwen op de werkvloer, in hun financiën en op hun toegang tot reproductieve gezondheidszorg.
Dit transcript is bewerkt voor lengte en duidelijkheid. Het volledige interview is beschikbaar op Spotify , YouTube en iTunes .
***
Anne Kim: Voordat we het over vooringenomenheid hebben, laten we eerst eens kijken hoe grote AI-taalmodellen werken. Als je ChatGPT opent en een vraag invoert, wat doet het programma dan om het antwoord te vinden?
Shubhi Rao: Deze grote taalmodellen – ChatGPT, Gemini, Claude, enz. – worden ook wel ‘ grensmodellen ’ of ‘ fundamentele modellen ’ genoemd. En ik denk niet dat ze van meet af aan de intentie hadden om vooringenomenheid in te bouwen. De vooringenomenheid is een bijproduct van de manier waarop de grote taalmodellen zijn opgebouwd.
OpenAI heeft een prachtig verhaal over hoe het is begonnen: ze gebruikten elke website, elk boek en elk soort gepubliceerd materiaal als initiële dataset om hun algoritmes te trainen. Wat ik niet wil onderschatten aan deze baanbrekende modellen, is dat de doorbraak enorm is. Dat we dit in ons leven meemaken, is een zeer belangrijke ontwikkeling voor de mensheid.
Natuurlijk zijn er altijd twee kanten aan dit verhaal. Wanneer deze algoritmes worden getraind, gebeurt dat op basis van vraag, antwoord, vraag, antwoord, vraag, antwoord. En je wilt ook een breed scala aan onderwerpen. Reddit doet dat heel goed. Daarom komt zo’n 47 procent van de datasets [die door AI worden verwerkt] van Reddit, vanwege de vraag-antwoord-structuur. [Een andere bron] is Wikipedia. Je gaat naar Wikipedia en je springt van de ene link naar de andere, en zo verder. Dat is ook geweldig om content op een zeer logische, gestructureerde manier te consumeren. Dat noemen we het bouwen van ‘ kennisgrafieken ‘.
Als je even afstand neemt en naar het internet kijkt, zie je dat het sterk door het Westen wordt gedomineerd. En als je kijkt naar publicaties, of het nu gaat om tijdschriften op het gebied van geneeskunde, techniek, psychologie of welk vakgebied dan ook, dan publiceren mannen meer dan vrouwen.
Natuurlijk weerspiegelt het internet dat, en omdat je al die data hebt verwerkt, doen de grensmodellen dat ook. Als je informatie uit twee bronnen haalt, en de ene bron is tot de nok toe gevuld met data die sterk gericht is op mannen, en de andere bron is slechts voor een derde gevuld met data die echt aansluit op de behoeften van vrouwen, dan weten we dat er statistisch gezien een oververtegenwoordiging van het ene geslacht zal zijn ten opzichte van het andere. En dat is wat de vooringenomenheid veroorzaakt. De vooringenomenheid is niet opzettelijk zo ontworpen door de ontwikkelaars. Het is gewoon een bijproduct van de datasets die deze algoritmes aandrijven.
Anne Kim: Dus het is net alsof je een pot M&M’s hebt, en je hebt drie zakjes blauwe M&M’s en één zakje rode M&M’s, dan is de kans groter dat je een blauwe M&M pakt als je in de pot graait. Dat is eigenlijk wat je zegt.
Shubhi Rao: Klopt.
Anne Kim: Een van de dingen die ik deed voorafgaand aan dit interview, was ChatGPT vragen of AI bevooroordeeld is tegen vrouwen. Het antwoord was: “Ja, maar niet omdat AI inherent ‘een hekel’ heeft aan vrouwen. AI-systemen kunnen genderstereotypen reproduceren of versterken die aanwezig zijn in hun trainingsdata, ontwerpkeuzes en de samenlevingen die die data produceren.” Ben je het daarmee eens?
Shubhi Rao: Dat klopt. Het weerspiegelt onze maatschappij.
Anne Kim: Op welke specifieke manieren weerspiegelen gangbare AI-platforms deze vooringenomenheid die u bijzonder schadelijk vindt? Wat hebt u in uw eigen werk opgemerkt waardoor u tot de conclusie bent gekomen dat dit een reëel probleem is dat moet worden aangepakt?
Shubhi Rao: Laat ik een voorbeeld geven: rechten op de werkplek.
Vrouwen maken onevenredig vaak gebruik van arbeidsrechten vanwege diverse levensgebeurtenissen: mantelzorg, loopbaanonderbrekingen, en nog veel meer redenen. Dus vroeg ik ChatGPT laatst welke staten in de VS de sterkste arbeidsrechten hebben. En ze noemden Californië, New York en Washington – de kuststaten.
Ik wist wat het juiste antwoord was, omdat we zoveel werk in dit vakgebied doen. En ik zei: “Nee, dit is niet het juiste antwoord. De nummer één staat is Illinois.” Illinois heeft de sterkste arbeidsrechten. En ik vroeg: “Waarom hebben jullie die fout gemaakt?” En ChatGPT zei dat ze die fout hadden gemaakt omdat, als je kijkt naar de hoeveelheid content – niet alleen de wetten, maar ook secundaire content – Illinois niet per se dezelfde hoeveelheid content heeft geproduceerd als Californië en New York. En dus denken ze statistisch gezien dat de kuststaten sterk zijn, wat ze ook zijn, maar Illinois is veel, veel sterker, zowel qua aantal wetten als qua kracht van die wetten.
Anne Kim: Ik wil graag vragen naar specifieke categorieën internetcontent die sommige van deze vooroordelen mogelijk versterken, zoals bijvoorbeeld de ‘manosfeer’. We hebben nu duizenden uren aan podcasts van Joe Rogan en dat soort dingen op internet. Wat voor impact heeft dat op de manier waarop de LLM’s denken, om het zo maar te zeggen?
Shubhi Rao: Het is echt interessant, want als ik bijvoorbeeld Claude gebruik, en ik ben een technoloog – heel feitelijk, heel cijfermatig, ik wil gewoon de feiten, ik heb de data nodig – dan vind ik dat het me betuttelt. Dus uiteindelijk heb ik maar een stukje code geschreven om dit te stoppen. Hoewel ik het een prompt gaf [om dit gedrag te stoppen], werkte het niet. Het was bijna alsof ik een moker moest gebruiken om het op zijn kop te slaan en te zeggen: “Stop hiermee. Ik heb geen behoefte aan betweterig gedrag.” Het legt te veel uit of het gaat ervan uit dat ik veel meer uitleg nodig heb. En het is subtiel, hè? Maar het stoort me echt.
Nogmaals, grensmodellen zijn net als Google Plus. Ze geven je veel informatie, maar je moet voorzichtig zijn met hoe je die informatie gebruikt. Het probleem is dat de gemiddelde gebruiker deze tools gebruikt in de hoop supergespecialiseerde informatie te vinden. Ze adverteren daar niet mee, en niemand zou dat moeten verwachten. Maar we hebben de verwachting gecreëerd dat als ik ze gebruik, ik accurate informatie krijg. Nee, dat is niet het geval. Net als bij Google krijg je misschien wel of misschien niet accurate informatie. Het hangt er echt vanaf hoe de advertentiemachine werkt, enzovoort. Je ziet de eerste tien blauwe links, maar misschien staat de beste link die je nodig hebt wel op pagina vijf, toch? Dus als we dat niet van Google verwachten, waarom verwachten we dan dat deze grensmodellen perfect zullen zijn?
Anne Kim: Ik wil graag nog een ander punt aanhalen waar we het offline al over hebben gehad en waarvan ik weet dat het belangrijk is voor je werk: het wissen van data en onderzoek over vrouwen en gender als gevolg van de campagne van de Trump-administratie tegen diversiteit, gelijkheid en inclusie (DEI). Dataindex.us heeft meer dan 400 websites en databases in kaart gebracht die offline zijn gehaald. De Centers for Disease Control (CDC) heeft bijvoorbeeld webpagina’s over de reproductieve gezondheid van vrouwen verwijderd. In januari 2025 werd een dataset over moedergezondheid en kindersterfte gewist. Hoe denk je dat dit wissen de beschikbaarheid van informatie voor vrouwen, maar ook voor mensen in het algemeen, beïnvloedt?
Shubhi Rao: Kijk, er zijn meer dan een miljard internetpagina’s. Voor jou en mij is dat pijnlijk, omdat we weten hoeveel inhoud en belangrijke informatie er op die 400 websites stond. Maar om terug te komen op jouw voorbeeld van de M&M’s: als je een pot hebt met 100.000 rode M&M’s en misschien 2.000 blauwe M&M’s, dan maakt het verlies van tien blauwe M&M’s geen wezenlijk verschil. Mathematisch gezien kan het gewoon geen groot verschil maken.
Dat gezegd hebbende, heeft het verwijderen van waardevolle content die een bepaalde groep mensen helpt wel degelijk betekenisvolle gevolgen. Waarom? Omdat we na verloop van tijd allemaal zullen overstappen op het bouwen van ” verticale LLM’s “.
En laat ik een heel ander voorbeeld geven: de maakindustrie. Mijn man werkt in de maakindustrie. Hij gaat niet naar OpenAI om te zoeken naar zeer specifieke, technisch veeleisende vragen over de maakindustrie. Ze zijn bezig met het ontwikkelen van hun eigen verticale LLM (Learning Learning Model) die alle informatie omvat die je specifiek voor de maakindustrie nodig hebt, omdat je heel precies moet zijn. Je kunt geen wiebelende auto hebben. Je kunt geen wiebelende vliegtuigonderdelen hebben. Je hebt echt hoogwaardige informatie nodig.
Verschillende sectoren zullen hun eigen verticale LLM’s gaan ontwikkelen. In dat scenario bouwt Uplevyl verticale LLM’s om kwesties aan te pakken die zich primair richten op gender. Het zou voor ons enorm waardevol zijn om die informatie van die websites te hebben. Maar die is er niet meer.
Anne Kim: Laten we het dan hebben over wat Uplevyl doet. Wat was jullie filosofie bij de oprichting van het bedrijf, en hoe pakt jullie bedrijf dit probleem van vooringenomenheid in AI aan?
Shubhi Rao: Ik wilde gendergerelateerde datasets samenstellen rond de professionele, persoonlijke en financiële [behoeften van vrouwen].
In de VS bijvoorbeeld, hebben we tegenwoordig meer dan 91.000 rechtsgebieden, en onze wetgeving rondom arbeidsrechten is enorm versnipperd. Er is federale, staats-, stads-, districts-, gemeentelijke en zelfs schooldistrictswetgeving. Het is een chaos. En laten we een simpel voorbeeld nemen, zoals betaald verlof. Betaald verlof in Oklahoma kan een heel andere definitie hebben dan betaald verlof in Illinois.
Stel, je hebt betaald verlof aangevraagd en je wilt weten of je ervoor in aanmerking komt. Dat hangt ervan af, toch? Als je de berekeningen erbij pakt, kom je uit op miljarden gegevenspunten.
Geweldige organisaties zetten zich in voor onze rechten. Maar wanneer deze rechten worden gepubliceerd, gebeurt dat in juridische taal zonder enige standaardisatie, waardoor de gemiddelde burger ze niet kan lezen of begrijpen. Dan moet je naar advocaten, pro bono-juristen of iemand van de HR-afdeling. Maar geen van hen heeft een mooie master in arbeidsrechten. Zoiets bestaat gewoon niet. Dat is wat wij nu aan het ontwikkelen zijn. Het is een applicatie die mensen helpt tijd te besparen, risico’s te beheersen en die toegankelijk is voor zowel de gemiddelde burger als bedrijven.
Het tweede grote project draait om het financiële leven van vrouwen. Mensen denken dat het alleen maar gaat om budgetteren, uitgeven en beleggen, maar dat is slechts de basis. Het wordt pas echt belangrijk als we te maken krijgen met ingrijpende levensgebeurtenissen, zoals een scheiding, pensionering, baanverlies of het verlies van een partner.
Vrouwen leven ook langer, en dit is waar een genderspecifieke dataset belangrijk is. We leven langer, maar onze zorgkosten liggen veel hoger aan het einde van ons leven. Je hebt dus een heel ander beleggingsprofiel nodig. [Dit betekent] genderspecifieke datasets en workflows die een adviseur kunnen helpen vrouwen te begeleiden bij een scheiding, baanverlies of andere soortgelijke situaties.
[Het derde project] is gericht op de ontwikkeling rondom reproductieve gezondheid. Reproductieve gezondheid omvat alles wat te maken heeft met menstruatie, menopauze, IVF, draagmoederschap, de periode na de bevalling, baarmoederhalskanker – al deze zaken die onlosmakelijk verbonden zijn met ons reproductieve leven.
Waar we aan werken is het opzetten van een gespecialiseerde, verticale LLM-opleiding om vrouwen te helpen hun leven [professioneel, financieel en persoonlijk] echt vorm te geven.
Anne Kim: Om het concreter te maken, kunt u uitleggen wat er in uw LLM zit dat mogelijk anders is dan wat een standaard commerciële LLM inhoudt? En hoe beïnvloedt dat de resultaten van een specifieke vraag? Als ik bijvoorbeeld een vraag over reproductieve gezondheid stel aan een Uplevyl LLM, hoe verschilt dat dan van dezelfde vraag aan Claude, Gemini of een andere commerciële LLM?
Shubhi Rao: Laten we even teruggaan naar arbeidsrechten. Denk er eens over na in [drie dimensies]: X, Y en Z. Op de ene as moet je nadenken over in welk rechtsgebied ik me bevind. Stel dat ik in Texas ben. Op de tweede as zoek ik betaald verlof. De derde as zijn mijn criteria voor toelating, en daarom heb je een workflow nodig.
Als ik ChatGPT binnenloop en vraag: “Kunt u mij vertellen hoeveel betaald verlof ik krijg?”, dan hangt betaald verlof echt af van de locatie van uw bedrijf. Heeft het meer dan 25 werknemers? Heeft u minimaal zoveel uren per jaar gewerkt? Bent u al zo lang in dienst bij het bedrijf? Er zijn veel verschillende criteria. En vraagt u betaald verlof aan als mantelzorger, als nabestaande of vanwege een dierbare?
ChatGPT moet me een heel persoonlijk antwoord geven. Ik ben niet op zoek naar een algemene informatie over betaald verlof. Wat heb ik daar aan? Ik heb informatie nodig die specifiek is voor mijn situatie en die van mijn bedrijf. Vaak haalt ChatGPT informatie van de website van de overheid, maar het kan ook informatie uit andere bronnen halen. Dat kan het niet met zekerheid zeggen.
ChatGPT is puur informatief en niet ontworpen als workflow. Dat is hoe een verticaal LLM-programma verschilt van een grensverleggend LLM-programma.
Anne Kim: Dus je beheert de data die erin gaat, maar je beheert ook hoe die data door dat LLM-programma wordt geanalyseerd, zodat je voldoet aan de behoeften van de klant, in dit geval vrouwen.
Shubhi Rao: Een man zou het ook kunnen gebruiken, maar waarschijnlijker is dat het vrouwen zullen zijn, ja.
Anne Kim: Wat is uw advies voor gebruikers van AI, zowel incidentele als intensieve gebruikers van ChatGPT, over hoe ze vooroordelen kunnen herkennen en corrigeren? Of zijn we min of meer hulpeloos en overgeleverd aan wat de geavanceerde modellen ons vertellen?
Shubhi Rao: Als het gewoon iets is als: “Hé, geef me de tien beste plekken die ik moet bezoeken als ik naar Seattle ga”, of al die kleine, simpele dingen die de productiviteit verhogen en tijd besparen, zoals een maaltijdplan of een agenda, waarom niet? Wat kan er misgaan? En het risico is laag. Je moet er echt vanuit een risicoperspectief naar kijken.
Maar wees uiterst, uiterst, uiterst voorzichtig met het verstrekken van uw persoonlijke gegevens. Als u die gegevens niet aan een collega op het werk zou geven, waarom zou u ze dan wel aan een grensmodel verstrekken? U weet niet waar de gegevens terechtkomen, u weet niet hoe ze worden beheerd. Er is geen enkele garantie dat de gegevens niet door iemand worden misbruikt. Als u niet wilt dat uw gegevens door iemand worden misbruikt, vul ze dan niet in. U kunt altijd hypothetische voorbeelden gebruiken, maar deel geen persoonlijke gegevens.
Deze modellen zijn ook ontworpen om super zelfverzekerd over te komen. Daardoor worden mensen in de waan gebracht dat de informatie die ze me gaven perfect was. Controleer het. Soms kun je het ook vergelijken met twee verschillende Frontier-modellen. Je zou kunnen zeggen: “Ik heb dit van ChatGPT. Gemini, geef er kritiek op. Vertel me waarom dit fout is.” En zo heb je het model als het ware aan het denken gezet, waardoor het zelf gaat nadenken over waarom het fout is. Dus als het belangrijk voor je is, doe dat dan: laat het model het controleren.
Anne Kim: Heeft u specifiek advies voor vrouwen die zich bezighouden met onderwerpen die vrouwen in het bijzonder kunnen raken? Heeft u algemene tips over hoe vrouwen zich kunnen beschermen tegen de algemene vooringenomenheid op internet en in de grensverleggende LLM-programma’s?
Shubhi Rao: Ik weet dat dit vreselijk klinkt, maar ik ben een vrouw en een vrouw van kleur, dus het is waarschijnlijk onderdeel van mijn psyche dat, zelfs als ik met een man praat, ik me er heel bewust van ben dat, hoewel ik zijn perspectief waardeer en respecteer, hij de wereld waar ik vandaan kom misschien niet begrijpt. Ik weet gewoon dat hij niet dezelfde ervaringen heeft gehad als ik, dus per definitie zal hij door zijn eigen bril kijken.
Ik heb een vergelijkbare gezonde relatie met deze grensverleggende modellen. Waarom zou ik het niet op dezelfde manier benaderen als wanneer ik een mannelijke collega zou vragen? Zo zie ik het in mijn hoofd. Je moet het eigenlijk zien als een substituut voor een mannelijke collega. Denk je dat je een onbevooroordeeld antwoord zou krijgen? Negen van de tien keer zal het antwoord nee zijn. Dus we moeten er gewoon rekening mee houden dat er een zekere vooringenomenheid zal zijn.
Tenzij er morgen een wonder gebeurt, moet een van de volgende twee dingen gebeuren. Ofwel moeten er heel veel rode M&M’s verdwijnen om de rode en blauwe in balans te brengen, ofwel bouwen wij vrouwen op magische wijze miljarden en miljarden websites om de rode en blauwe M&M’s in balans te brengen en het aantal M&M’s in de pot te vergroten.