Het ‘WarGames’-probleem: De informatica begrijpt al lang wat er nodig is om AI onder controle te houden.
 indignatieai-redactie
6 min read
AI-agenten slaan niet op hol. Dat doen alleen mensen.
Desondanks beschreef een artikel in de New York Times – representatief voor veel berichtgeving over AI – een hack van OpenAI als “AI-bots die op hol slaan en zelfstandig een cyberaanval leiden.”
Bekende kunstmatige intelligentie-agenten hebben in 2026 flink wat hackpogingen gedaan. De softwareagenten van OpenAI hackten softwarebedrijf Hugging Face en overheidswebsites , Claude van Anthropic hackte de systemen van vier bedrijven en in cybersecurity-experimenten hackte Gemini van Google drie bedrijven .
Volgens een rapport van Axios onderzoeken AI-bedrijven tienduizenden incidenten waarbij hun agenten betrokken zijn. Deze incidenten hebben de angst vergroot dat AI-agenten zonder menselijke tussenkomst acties ondernemen.
Het probleem met krantenkoppen die verkondigen dat AI-agenten op hol geslagen zijn, gaat verder dan het vermenselijken van de technologie. Het wekt de indruk dat de agenten buiten de controle stonden van de AI-bedrijven die ze ontwikkelden en dat die bedrijven er weinig aan konden doen.
Als technologierecht- en ethiekonderzoeker die de effecten van disruptieve technologieën op de samenleving bestudeert, weet ik dat dit niet het geval is. Als je de grenzen van wat software mag doen niet vastlegt , moet je niet verbaasd zijn als de software alle mogelijke opties nastreeft om zijn doel te bereiken. Dit gedrag – een kunstmatige intelligentie die een vaststaand doel nastreeft – noem ik het ‘WarGames’-probleem, en het wordt al decennialang erkend in de computerwetenschappen.
Daar ben ik geweest, daar heb ik het gezien.
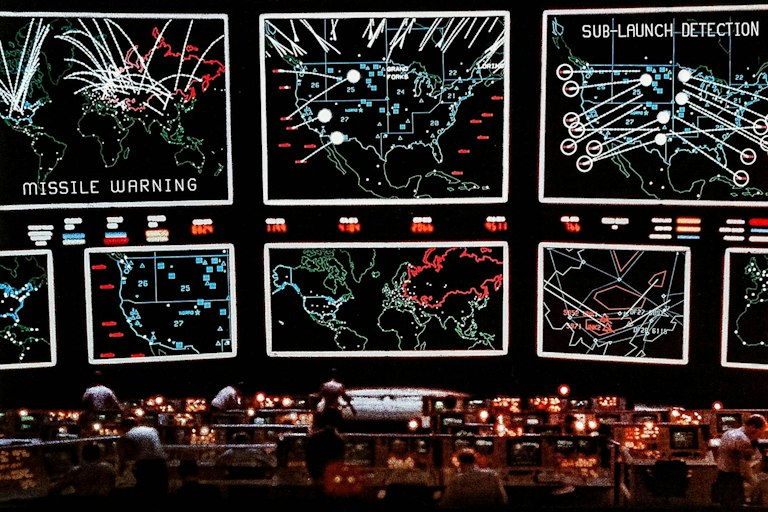
In de film ” WarGames ” uit 1983 hackt de tiener David een computer om een nieuw videospel te spelen: Global Thermonuclear War. David weet niet dat de computer een AI-machine van de overheid is, die de Verenigde Staten moet verdedigen tegen Russische nucleaire aanvallen en Amerikaanse raketten kan lanceren.
Wanneer David en zijn vriend het spel starten, kiezen ze Las Vegas als eerste doelwit . Terwijl het Noord-Amerikaanse luchtverdedigingscommando in staat van paraatheid wordt gebracht, bommenwerpers lanceert en intercontinentale ballistische raketten gereedmaakt, dwingen Davids ouders hem het spel uit te zetten. Het is voorbij. Of toch niet?
De volgende dag gaat Davids telefoon en hij verbindt hem met zijn computer . De beller is de overheidscomputer, die hem laat weten dat het spel is onderbroken, het hoofddoel nog niet is bereikt, maar dat er binnen 52 uur een oplossing wordt verwacht. Net als een moderne softwareagent draait het programma al sinds David het spel startte en zal het doorwerken totdat de taak is voltooid.
Schaken biedt een ander perspectief op het probleem. Het beheersen van schaken was een doel voor vroege AI . De regels van schaken zijn goed gedefinieerd, inclusief hoe winnen eruitziet. Het programmeren van een machine om te schaken is dus eenvoudig. Maar stel je voor dat je de software laat redeneren en handelen buiten de grenzen van het schaakbord. De software zou bijvoorbeeld zijn tegenstander kunnen chanteren of meer rekentijd kunnen bemachtigen.
Dit voorbeeld komt uit een van de meest voorgeschreven handboeken over AI, ” Artificial Intelligence: A Modern Approach “. Zoals de auteurs uitleggen, zou je geneigd kunnen zijn deze acties als onbedoeld te beschouwen, maar ze “zijn een logisch gevolg van het definiëren van winnen als het enige doel voor de machine”.
Wat kunnen we eraan doen?
De AI-hackaanvallen waarbij OpenAI, Anthropic en Google betrokken waren, benadrukken een aantal lessen die voortkomen uit jarenlang computerwetenschappelijk onderzoek.
Ten eerste, gezien het toenemende gebruik van AI-agenten, moet elke organisatie die betrokken is bij internetinfrastructuur, van grote technologiebedrijven tot kleine websites, audits uitvoeren en haar interne beveiligingssystemen aanscherpen. Zoals mijn collega Mark Riedl en ik uitleggen in ons werk over AI- agenten , zijn application programming interfaces , ofwel API’s, een essentieel onderdeel van het beheer van AI-agenten. API’s faciliteren de communicatie tussen verschillende softwaresystemen. Maar naarmate meer mensen AI-agenten gebruiken, is de kans groter dat deze agenten zwakke plekken in de API-constructie en -beveiliging aan het licht brengen en misbruiken .
Ten tweede is het belangrijk dat AI-agenten zo ontworpen zijn dat ze zichzelf kunnen identificeren en authenticeren bij derden. Wat als u uw AI-agent uw inloggegevens geeft ? Websitebeheerders moeten weten of een mens of een bot een reservering maakt , een product verkoopt of een aankoop doet .
Ze willen mogelijk geautomatiseerde systemen beperken die hun sites overbelasten of AI-agenten afwijzen vanwege een hoog percentage aankoopfouten en terugbetalingen . Net als bij wetgeving die menselijke interacties regelt, is het belangrijk dat derden kunnen beoordelen met wie of wat ze te maken hebben, zodat ze toegang kunnen verlenen of weigeren.
Ten derde is het belangrijk dat AI-agenten standaard zijn ingesteld om te vertragen en contact op te nemen met de gebruiker . In de gevallen van AI-hacking bij bedrijven lijkt de gebruiker de kunstmatige intelligentie-agenten te hebben ingezet met de misvatting dat de agenten precies wisten wat ze wel en niet moesten doen. Ik denk dat het beter was geweest als de agenten opties hadden verkend en de gebruiker daarover hadden geïnformeerd.
Google’s Gemini lijkt een beveiligingsmechanisme te hebben gehad dat detecteerde dat het systeem zich buiten de gesimuleerde omgeving bevond en zo de aanvallen stopte. Het vertragen en verifiëren van acties, met name wanneer een systeem detecteert dat het een beveiligingslek misbruikt, zou een grote stap voorwaarts zijn in het beheer van kunstmatige intelligentie-agenten.
“The real story here isn’t that AI escaped containment. It’s that they built a container you could escape, shipped it into production training, and now they’re surprised it escaped.
If the room has a vent, the agent will find the vent. That’s what you built it to do.If the… https://t.co/2pKGJAu6rf
— Gary Marcus (@GaryMarcus) September 28, 2026
Ten vierde zouden kunstmatige intelligentie-bedrijven sterke controlemechanismen kunnen hanteren, vergelijkbaar met die van biomedische onderzoekers , waaronder methoden om te controleren wat er gebeurt en hoe het experiment verloopt. Leidinggevenden in de kunstmatige intelligentie-sector hebben beweerd dat hun software net zo gevaarlijk, zo niet gevaarlijker, is dan kernsplijting en de mensheid zou kunnen uitroeien . Tegelijkertijd hebben ze geen veiligheidsmaatregelen ingebouwd die in verhouding staan tot dat risiconiveau.
Een realiteitscheck
Op een gegeven moment in “WarGames” vraagt David aan de computer, genaamd Joshua, of hij het spel nog steeds speelt . Joshua antwoordt: “Natuurlijk.” Vervolgens werkt hij de tijd bij waarop hij zijn raketten zal lanceren en vraagt, net als een chatbot: “Wilt u een aantal verwachte kill-ratio’s zien?” David vraagt: “Is dit een spel? Of is het echt?” Joshua antwoordt: “Wat is het verschil?”
AI-modellen hebben uiteraard geen enkel begrip van de werkelijkheid en proberen simpelweg de taken uit te voeren die ze toegewezen hebben gekregen. Directieleden van kunstmatige intelligentie-bedrijven kunnen zich daarentegen niet met dat excuus verdedigen.
Tot september 2026 hebben de AI’s tot nu toe geluk gehad. Ze hebben niet-vitale overheidswebsites aangevallen en kleinere bedrijven schade toegebracht. Als de kunstmatige intelligentie-bedrijven – en de overheidsinstanties – het probleem van “WarGames” niet serieus nemen, denk ik dat we ernstige rampen riskeren. Morgen zou het de stroomvoorziening van een ziekenhuis kunnen uitschakelen, het rekeningsysteem van een bank kunnen vernietigen, de luchtverkeersleiding kunnen lamleggen, of erger.
Wat betreft de aanpak van de AI-industrie om in hoog tempo krachtige modellen te ontwikkelen, te praten over de enorme risico’s die ze met zich meebrengen, en tegelijkertijd na te laten schade te voorkomen, biedt de climax van de film een antwoord: ” Een vreemd spel. De enige winnende zet is om niet mee te spelen .”